Günümüzde Matematik · Günümüz
Yapay zekânın matematiği: Vektörler, matrisler, türev ve olasılık
Yapay zekâ sistemlerinin arkasında gizemli bir sır değil, temellerini lisede gördüğümüz matematik var: sayı listesi olarak vektörler, matris çarpımı, türevle hatayı azaltma ve olasılık. Küçük örneklerle abartısız bir tur.
Yazan: matematikce editörlüğü 6 dk okuma
Bir fotoğraftaki kediyi tanıyan, bir cümleyi başka dile çeviren ya da sorulara metinle cevap veren yazılımlar bazen düşünen makineler gibi anlatılır. Bu sistemlerin nasıl çalıştığını anlamak için büyülü bir açıklamaya gerek yok. Arkalarında büyük ölçekte uygulanmış, ama özünde tanıdık bir matematik vardır.
Bu yazıda makine öğrenmesinin dört temel yapı taşını küçük örneklerle ele alacağız: verileri sayı listelerine dönüştüren vektörler, bu listeleri dönüştüren matrisler, hatayı adım adım azaltan türev ve belirsizliği ifade eden olasılık. Örneklerimiz bilerek küçük tutuldu; gerçek sistemler aynı fikirleri milyonlarca, hatta milyarlarca sayıyla uygular.
Her şey sayıya dönüşür: vektörler
Bilgisayar yalnızca sayılarla çalışır. Bu yüzden makine öğrenmesinin ilk adımı, veriyi sayı listelerine çevirmektir. Matematikte sıralı sayı listelerine vektör denir.
Siyah-beyaz bir fotoğraf, her pikselin parlaklığını gösteren sayılardan oluşan uzun bir listedir. Bir ses kaydı, zamanın her anındaki basıncı gösteren sayılardır. Kelimeler de sayılara dönüştürülebilir. Bunun için her kelimeye, anlamca yakın kelimelerin birbirine yakın düşeceği biçimde bir vektör atanır.
Bunu hayalî ve çok küçük bir örnekle görelim. Her kelimeyi yalnızca üç sayıyla temsil edelim:
- kedi = (0,9; 0,8; 0,1)
- köpek = (0,8; 0,9; 0,2)
- otomobil = (0,1; 0,2; 0,9)
İki vektörün ne kadar aynı yöne baktığını kosinüs benzerliğiyle ölçebiliriz. İki vektörün karşılıklı bileşenlerini çarpıp toplarız, sonra vektörlerin uzunluklarının çarpımına böleriz. Sonuç 1’e yaklaştıkça vektörler aynı yöne bakar.
- kedi ile köpek: (0,72 + 0,72 + 0,02) ÷ (√1,46 × √1,49) ≈ 0,99
- kedi ile otomobil: (0,09 + 0,16 + 0,09) ÷ (√1,46 × √0,86) ≈ 0,30
Bu hayalî sayılarda kedi ile köpek birbirine çok yakın, otomobil ise uzak çıktı. Gerçek sistemlerde bu sayıları bir insan elle yazmaz. Sayılar büyük veri kümelerinden öğrenilir ve üç değil, çok daha fazla boyut kullanılır.
Matrisler: bir katman ne yapar?
Yapay sinir ağları katmanlardan oluşur. Bir katman, gelen vektörü önce bir matrisle çarpar, ardından bir sayı listesi ekler ve sonucu basit bir fonksiyondan geçirir.
Küçük bir örnek kuralım. Girdi vektörümüz x = (1, 2) olsun. Katmanın ağırlık matrisinin iki satırı (0,5; −1) ve (2; 1), eklenecek sayılar ise (0,5; −1) olsun.
- Matrisle çarpma: Birinci satır için 0,5 × 1 + (−1) × 2 = −1,5. İkinci satır için 2 × 1 + 1 × 2 = 4. Sonuç (−1,5; 4).
- Ekleme: (−1,5 + 0,5; 4 − 1) = (−1; 3).
- Fonksiyondan geçirme: Sık kullanılan bir seçim, negatif sayıları sıfıra çeviren ve pozitifleri olduğu gibi bırakan fonksiyondur: f(t) = en büyük(0, t). Sonuç (0; 3).
Bu kadar. Bir katman, matris çarpımı, toplama ve basit bir kesme işleminden ibarettir. Gücü, bu katmanların üst üste çok sayıda dizilmesinden ve matrislerdeki sayıların doğru seçilmesinden gelir. Peki bu sayılar nasıl seçilir?
Öğrenmek, hatayı azaltmaktır
Makine öğrenmesinde “öğrenmek”, modelin tahminleri ile gerçek cevaplar arasındaki farkı ölçen bir hata fonksiyonunu küçültmek demektir. Bunu tek bir ayarlanabilir sayıyla, elle izlenebilecek bir modelle görelim.
Bir manavda elmanın kilosunun fiyatını bilmediğimizi, ama üç satışın kaydını gördüğümüzü düşünelim: 1 kg için 2,5 TL, 2 kg için 5 TL, 4 kg için 10 TL. (Sayılar hayalîdir.) Modelimiz fiyat = w × kilogram olsun. Amacımız w’yi bulmak.
Hata olarak, tahmin ile gerçek değer arasındaki farkların karelerinin ortalamasını alalım:
L(w) = [(w − 2,5)² + (2w − 5)² + (4w − 10)²] ÷ 3
Biraz düzenlersek (2w − 5)² = 4(w − 2,5)² ve (4w − 10)² = 16(w − 2,5)² olduğunu görürüz. Böylece L(w) = (1 + 4 + 16) × (w − 2,5)² ÷ 3 = 7(w − 2,5)² olur. Bu bir paraboldür ve en küçük değerini w = 2,5’te alır.
Burada cevabı gözle görebiliyoruz. Gerçek modellerde ise milyonlarca w vardır ve parabolü çizmek mümkün değildir. Onun yerine türevi kullanırız.
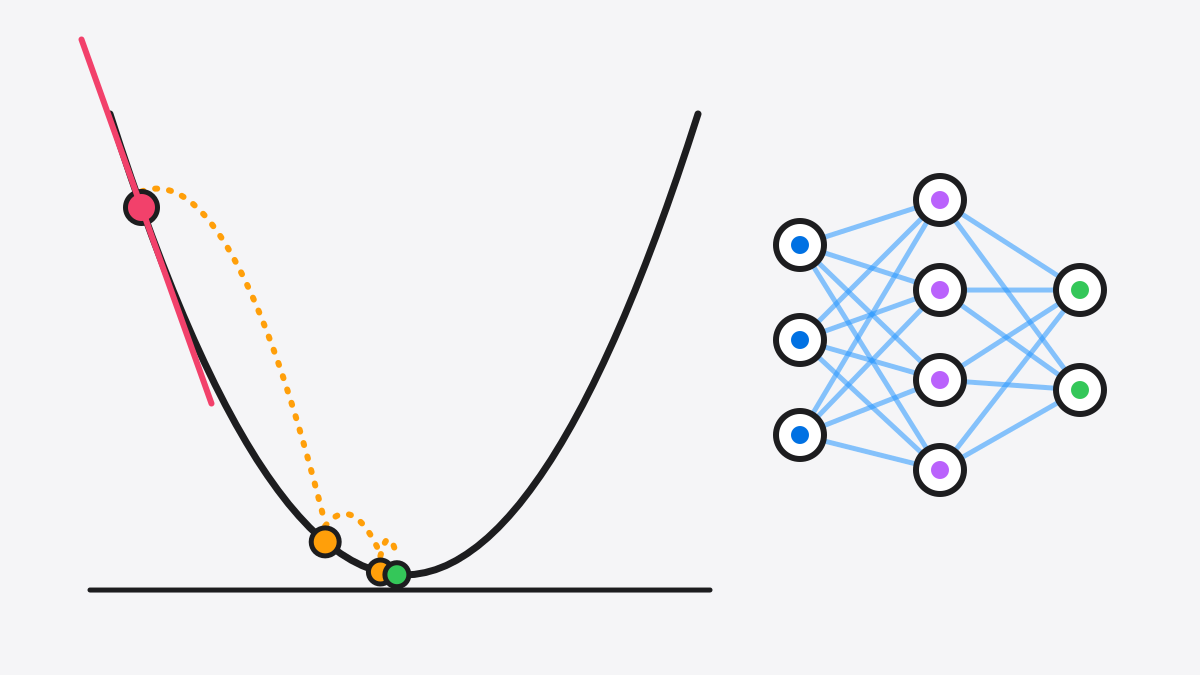
Gradyan inişi: eğime bakıp aşağı adım atmak
Türev, bir fonksiyonun o noktadaki eğimidir. Eğim pozitifse w’yi artırmak hatayı büyütür, negatifse küçültür. O hâlde w’yi eğimin tersi yönünde biraz kaydırmak mantıklıdır:
w_yeni = w − η × L′(w)
Buradaki η (eta) adım büyüklüğüdür ve öğrenme oranı diye adlandırılır. Bizim örneğimizde L′(w) = 14(w − 2,5). η = 0,05 seçelim ve w = 0’dan başlayalım.
- L′(0) = 14 × (−2,5) = −35. w = 0 − 0,05 × (−35) = 1,75.
- L′(1,75) = 14 × (−0,75) = −10,5. w = 1,75 + 0,525 = 2,275.
- L′(2,275) = 14 × (−0,225) = −3,15. w = 2,275 + 0,1575 = 2,4325.
- Bir adım daha: w ≈ 2,4798.
Her adımda 2,5’e olan uzaklık 0,3 katına iniyor: 2,5 → 0,75 → 0,225 → 0,0675. Adım büyüklüğü önemlidir. η = 0,2 seçseydik her adımda uzaklık −1,8 ile çarpılır, w dibe inmek yerine giderek büyüyen salınımlarla uzaklaşırdı.
Bu yöntemin kökleri 19. yüzyıla uzanır. Fransız matematikçi Augustin-Louis Cauchy, 1847’de denklem sistemlerini çözmek için en dik iniş yönünde ilerleme fikrini yayımladı. Çok değişkenli durumda her ağırlık için ayrı bir kısmi türev hesaplanır. Bu türevlerin oluşturduğu vektöre gradyan denir. Katmanlı ağlarda bu türevler, zincir kuralını sondan başa doğru verimli biçimde uygulayan geri yayılım yöntemiyle hesaplanır. Bu yöntem 1986’da yayımlanan bir çalışmayla geniş çevrelerde tanındı.
Olasılık: kesinlik yerine dağılım
Birçok yapay zekâ sistemi tek bir cevap vermek yerine seçenekler üzerine bir olasılık dağılımı üretir. Bir fotoğraf sınıflandırıcı “kedi”, “köpek” ve “tavşan” için birer puan hesaplayabilir. Metin üreten modeller de benzer biçimde, sıradaki kelime için olası seçeneklere olasılık atar.
Puanları olasılığa çevirmenin yaygın bir yolu softmax fonksiyonudur. Her puanın e tabanındaki kuvveti alınır ve toplama bölünür. Puanlar 2, 1 ve 0 olsun:
- e² ≈ 7,389; e¹ ≈ 2,718; e⁰ = 1. Toplam ≈ 11,107.
- Olasılıklar: 7,389 ÷ 11,107 ≈ 0,665; 2,718 ÷ 11,107 ≈ 0,245; 1 ÷ 11,107 ≈ 0,090.
Sonuçların toplamı 1’dir ve en yüksek puan en yüksek olasılığı alır. Ama %66,5 kesinlik değildir. Model, üç denemeden birinde yanılabileceğini bu sayıyla kendisi söylemektedir.
Abartısız bir bakış
Bu matematik güçlüdür ama sınırları da vardır. Bir model, verideki örüntüleri istatistiksel olarak yakalar. Veride olmayan durumlarda yanılabilir, verideki çarpıklıkları tekrarlayabilir ve yanlış bir cevabı yüksek olasılıkla sunabilir. Bu yüzden yapay zekâ çıktıları, özellikle önemli kararlarda, insan denetimiyle ve doğrulamayla kullanılmalıdır. Modelin ne yaptığını anlamak için vektör, matris, türev ve olasılık kavramlarını bilmek, hem abartılı beklentilerden hem de gereksiz korkulardan korur.
Neden önemli?
Bu yazıdaki araçların neredeyse hepsi lise matematiğinde temelleriyle yer alır. AYT’deki türev, bir fonksiyonun en küçük değerini bulmanın ve eğimi yorumlamanın yoludur; gradyan inişi bunun sayısal hâlidir. Fonksiyonlar, parabol, üslü sayılar ve olasılık da TYT ve AYT konuları arasındadır. Konu listesini ne öğrettiğimizi anlattığımız sayfada bulabilirsiniz.
Türevin tarihini merak ediyorsanız Newton ve Leibniz yazımız iyi bir başlangıçtır. Makinelerin neyi hesaplayabileceği sorusunun kökenleri ise Turing makinesi yazımızda anlatılıyor.
Kapanış
Yapay zekâ sistemleri karmaşık görünür, çünkü çok büyük ölçekte çalışırlar. Ama tek bir adımı yakından incelediğimizde karşımıza bir vektör, bir matris çarpımı, bir türev ve bir olasılık dağılımı çıkar. Elma fiyatını dört adımda bulan küçük modelimiz ile milyarlarca parametreli bir model aynı temel soruyu sorar: Hatayı azaltmak için hangi yöne ne kadar adım atmalıyım?